线性回归及回归算法
四月 18, 2023
咳咳。之前因为有考试及生活中的琐事要处理,所以隔了很久才发布了这篇博客
回归算法的应用
- 对于回归问题和如何使用线性回归算法做出最基础的判断
- 回归问题一般目标值是连续性的值,而分类问题的目标值是离散型的值。
- 回归处理能做的预测
- 预测房价
- 销售额的预测
- 设定贷款额度
- 总结:可以根据事物的相关特征预测出对应的结果值,重点就是预测的能力
- 线性回归在生活中的映射(现实生活中就有线性回归):生活案例【预测学生的期末成绩】:
- 期末成绩的制定:0.7*考试成绩+0.3平时成绩,则该例子中,特征值为考试成绩和平时成绩,目标值为总成绩。从此案例中大概可以感受到
- 回归算法预测出来的结果其实就是经过相关的算法计算出来的结果值!
- 每一个特征需要有一个权重的占比,这个权重的占比明确后,则就可以得到最终的计算结果,也就是获取了最终预测的结果了。
- 期末成绩的制定:0.7*考试成绩+0.3平时成绩,则该例子中,特征值为考试成绩和平时成绩,目标值为总成绩。从此案例中大概可以感受到
问题:假如现在有一套房子,面积为76.8平米,那么这套房子应该卖多少钱呢?也就是如何预测该套房子的价钱呢?
下图中散点的分布情况就是面积和价钱这两个值之间的关系,那么如果该关系可以用一个走势的直线来表示的话,那么是不是就可以通过这条走势的直线预测出新房子的价格呢?
1 | #现在有一组售房的数据 |

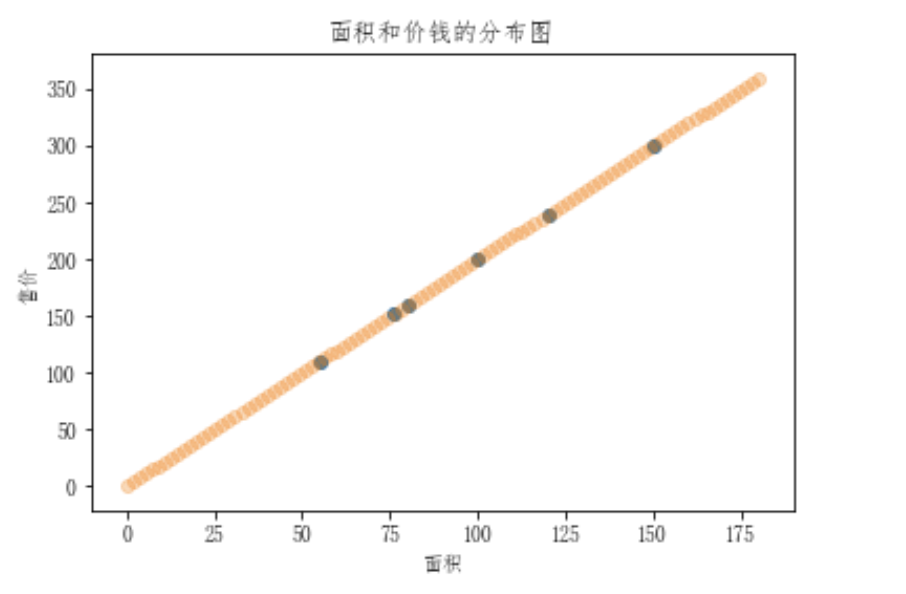
- 散点的趋势:
- 在上图中使用了一条直线来表示了房子的价格和面子对应的分布趋势,那么该趋势找到后,就可以基于该趋势根据新房子的面积预测出新房子的价格。
- 线性回归的作用:
- 就是找出特征和目标之间存在的某种趋势!!!在二维平面中,该种趋势可以用一条线段来表示。
- 该趋势使用什么表示呢?—》线性方程:
- 在数学中,线性方程y = wx就可以表示一条唯一的直线。那么在上述售房数据中,面积和价格之间的关系(二倍的关系)其实就可以映射成
- 价格 = 2 * 面积 ==》y=2x,这个方程就是价格和面积的趋势!也就是说根据该方程就可以进行新房子价格的预测
- 标准的线性方程式为:y = wx + b,w为斜率,b为截距。是否带上b,得具体情况具体分析。y=wx,如果x为0,则y必定为0,那就意味着趋势对应的直线必过坐标系的原点(0,0),如果带上b值,则直线不过原点。如果上有图的趋势直线过原点的话,趋势就会不准。加b的目的是为了使得趋势对应的直线更加具有通用性!!!
- 如果目标值有可能为0的话,就带上b,否则不带b。
- 在数学中,线性方程y = wx就可以表示一条唯一的直线。那么在上述售房数据中,面积和价格之间的关系(二倍的关系)其实就可以映射成

在预测中,肯定也会出现一种情况,误差
- 那我们如何处理误差呢?在处理误差之前,我们必须先要知道一个回归算法的特性:
- 回归算法是一个迭代算法。所谓的迭代就好比是系统版本的迭代,迭代后的系统要比迭代前的系统更好。
- 当开始训练线性回归模型的时候,是逐步的将样本数据带入模型对其进行训练的。
- 训练开始时先用部分的样本数据训练模型生成一组w和b,对应的直线和数据对应散点的误差比较大,通过不断的带入样本数据训练模型会逐步的迭代不好(误差较大)的w和b从而使得w和b的值更加的精准。
- 官方解释:迭代是重复反馈过程的活动,其目的通常是为了逼近所需目标或结果。每一次对过程的重复称为一次“迭代”,而每一次迭代得到的结果会作为下一次迭代的初始值。
- API
- 最小二乘(正规方程):
1
from sklearn.linear_model import LinearRegression
- 回归算法是一个迭代算法。所谓的迭代就好比是系统版本的迭代,迭代后的系统要比迭代前的系统更好。

回归模型的评价指标
- 回归类算法的模型评估一直都是回归算法中的一个难点,回归类与分类型算法的模型评估其实是相似的法则— —找真实标签和预测值的差异。只不过在分类型算法中,这个差异只有一种角度来评判,那就是是否预测到了正确的分类,而在我们的回归类算法中,我们有两种不同的角度来看待回归的效果:
- 第一,我们是否预测到了正确或者接近正确的数值(因为误差的存在)。
- 第二,我们是否拟合到了足够的信息。(是否模型预测的结果线性和样本真实的结果的线性更加吻合)
- 这两种角度,分别对应着不同的模型评估指标。
是否预测到了正确的数值
- 回忆一下我们的RSS残差平方和,它的本质是我们的预测值与真实值之间的差异,也就是从一种角度来评估我们回归的效力,所以RSS既是我们的损失函数,也是我们回归类模型的模型评估指标之一。但是,RSS有着致命的缺点: 它是一个无界的和,可以无限地大或者无限的小。我们只知道,我们想要求解最小的RSS,从RSS的公式来看,它不能为负,所以 RSS越接近0越好,但我们没有一个概念,究竟多小才算好,多接近0才算好?为了应对这种状况,sklearn中使用RSS 的变体,均方误差MSE(mean squared error)来衡量我们的预测值和真实值的差异:
- 均方误差,本质是在RSS的基础上除以了样本总量,得到了每个样本量上的平均误差。有了平均误差,我们就可以将平均误差和我们的标签的取值范围(最大值和最小值)在一起比较,以此获得一个较为可靠的评估依据。(查看这个错误有多严重)。
- 因为标签的最大值和最小值可以表示标签的一个分部情况,那么将其最大值和最小值和平均误差比较就可以大概看出在每个样本上的误差或者错误有多严重。
是否拟合了足够的信息
- 对于回归类算法而言,只探索数据预测是否准确是不足够的。除了数据本身的数值大小之外,我们还希望我们的模型能够捕捉到数据的”规律“,比如数据的分布规律(抛物线),单调性等等。而是否捕获到这些信息是无法使用MSE来衡量的。

- 来看这张图,其中红色线是我们的真实标签,而蓝色线是我们模型预测的值。这是一种比较极端,但的确可能发生的情况。这张图像上,前半部分的拟合非常成功,看上去我们的真实标签和我们的预测结果几乎重合,但后半部分的拟合 却非常糟糕,模型向着与真实标签完全相反的方向去了。对于这样的一个拟合模型,如果我们使用MSE来对它进行判 断,它的MSE会很小,因为大部分样本其实都被完美拟合了,少数样本的真实值和预测值的巨大差异在被均分到每个 样本上之后,MSE就会很小。但这样的拟合结果必然不是一个好结果,因为一旦我的新样本是处于拟合曲线的后半段的,我的预测结果必然会有巨大的偏差,而这不是我们希望看到的。所以,我们希望找到新的指标,除了判断预测的 数值是否正确之外,还能够判断我们的模型是否拟合了足够多的,数值之外的信息。
查看评论